monorepo + GitHub + CircleCI の制約、あるいはなぜ私は動的ワークフロー生成という黒魔術を採用するに至ったのか
Treasure Data では4月に新しいサービス Treasure AI Studio を発表しました*1。この製品の開発は迅速に行う必要があり、monorepo 構成にして FE 側と BE 側を同一リポジトリにおくことで AI Agent がシームレスに開発できることを狙いました。この構成は AI Agent の面ではよかったものの、CI/CD については課題に直面しました。対応策を考えて現在ではある程度の解決を見ているのでここに詳細を記そうと思いますが、改善アイデアなどありましたら教えてください。
問題定義
前提
- monorepo (Rails + 複数 Go の web API 複数 + FE など)
- かなり簡略化していますが詳細は sada の発表をお待ちください https://treasure-data.connpass.com/event/391551/
- 簡単のため、component は A と B があって、
test-A,deploy-$stage-A,test-B,deploy-$stage-Bがあるとしましょう。$stage は development, staging, production です。 - 型定義などの共有をしないタイプ。 polyrepo をくっつけただけの monorepo です
- GitHub
- CircleCI
やりたいこと
- 必要なテストだけ走らせること、不要なテストが走らないこと
- PR ごとに健全性の確認ができること、すなわち必要なテストが通ったときだけ PR をマージできること
解決策
棄却されたアプローチ1: naive 版
GitHub の status check に circleci/test-A, circleci/test-B と書く。
これでは component A の変更だけの場合に B のテストが走ってしまいます。
棄却されたアプローチ2: path-filtering
https://circleci.com/developer/orbs/orb/circleci/path-filtering
CircleCI では公式 orb の path-filtering によって、特定パスの変更に基づいて後続の WF を変更することができます。すなわち componentA/ 配下の変更があるときのみ test-A だけを走らせることができます。
しかし、これではPRの健全性の担保はできません。GitHub の required status check は動的には変更できず、また複雑な条件も設定できません。そのため、 status check で test-A, test-B の両方を書かなければ片方のテストが落ちても通ってしまうし、両方を書いてしまうと test-A だけしか走らない PR は永遠に status check が成功しません。
棄却されたアプローチ3: generator + continue + dynamic require
path-filtering だけでは status check を突破することはできませんでした。 test-A が必要なのか、test-B が必要なのか、あるいは両方とも必要なのか、両方ともいらないのか。そういったことを判断したうえで CI 全体としての red/green を代表させるジョブがなくては status check を突破することはできません。
一つは polling というアイデアになるでしょう。test-A, test-B というジョブ名がわかっているので CircleCI の API を叩くことで success, failure (あるいは待ち)を決定すればよいわけです。
一方で、条件に応じて後続 WF を変更するという path-filtering のアイデアを突き詰めることもできそうです。path-filtering は内部的には continuation orb を使っていて、これが後続 WF を変更させるものになります。
https://circleci.com/developer/orbs/orb/circleci/continuation
continuation orb で指定する後続 WF 定義は git 管理されている必要はなく continue する瞬間にファイルとして存在すればよいことになっています。つまり動的に生成することが可能です。 WF 定義の動的生成と聞くと黒魔術じゃんと思う方も多いと思いますが、個人的には慣れたものです*2。
まあたかだか CI 定義くらいなら多少黒魔術を使っても問題ないでしょう。要は ci-success ジョブを定義しその require に test-A を設定するか、test-B を設定するかを判断して宣言すればよいのです。
またこの手法ならば polling とは違ってジョブ自体が走らないため無駄に computing cost がかかりません。
workflows:
  my-workflow:
    jobs:
      - test-A # ここがあったりなかったりする
      - test-B # ここがあったりなかったりする
      - ci-success:
          requires: # ここが [test-A], [test-B], [test-A, test-B] のいずれかをとる、あるいは丸ごとなくなる
これはかなりうまく動き、実際 main にもマージされました。しかし運用していく中で新たな制約が判明します。
ci-success は echo "ok" するだけなので常に success します。一方でトリガーされるまでは not_run のままです。test-B を require している ci-success は test-B が失敗したときには not_run のままになってしまうのです。これは PR の status check としてはうまく機能します。PR の status check は green を要求するから not_run ならば status check が通らずマージできません。しかし、Merge Queue を有効化している場合に Merge Queue から取り除かれるためには、not_run ではなく failed として明示的に red なステータスにしなければなりません。そうでないと Merge Queue 内でタイムアウトするまで待ち続けてしまいます。
いかに丁寧にPRを作成しようと外部サーバーの不安定さなどで CI が落ちることはよくあるので、この Merge Queue でこっそりタイムアウトするまで待ってしまうまま放置するわけにはいきません。
採用されたアプローチ: generator + continue + polling
結局、ci-success は polling することにしました。コストが無駄にかかっているような気はしますが許容範囲でしょう。
WF 生成スクリプトの実装は極力シンプルに保ちました。実際に走る定義ファイルがコミットされていないという状態なので、スクリプトのシンプルさは重要です。またテストも書いており、最初の WF 実行を test → 生成 → 生成物の print → continue という構成にしてテストが毎回実行されることと、生成結果を少なくとも目で確認できる状態を保っています。また、実際のジョブ名から定義が見えないと面倒なため、ジョブ定義自体は yaml ファイルに書いてコミットすることで最低限 grep でひっかけられることを担保しています。
基本構成は .circleci/templates/ 配下にコンポーネント毎の定義ファイルをもっておき(.circleci/templates/componentA.yaml)*3、全コンポーネントの定義ファイルをまとめたものから枝刈りをしていくことになります。枝刈りの方式は branch の種別ごとに変わります。branch 種別は、3つあり、main (test + hold 付きでstaging, production deployment), development (test + development 環境への自動デプロイ) *4, topic (test のみ)となっています。main ならば development のデプロイを削り、development ならば staging, production を削り、topic ならば deploy 系を全部削るような感じです。
ここまで読んで、結局 ci-success で polling するならば動的生成は不要では?と思った方もいるかもしれません。一理あります。しかし、実際には 10 コンポーネントあること、また development ブランチでは自動デプロイをしたいこと、development 環境が実は2つあることなどを考えると、動的生成によって定義ファイルが簡単になったことにも価値があるかなと思って戻す検討はしていません。また、例えば自動デプロイをする development ブランチにおいて CI の成功とは test だけでなく deploy も含むでしょう。 test-A 以外に deploy-development-A も ci-success の監視対象にするべき、というロジックをスクリプトとして表現できるのは利点ともいえるでしょう。
どうしてこうなった?
ここまでいろいろと対応してきたわけですが。PR 単位で必要なテストを走らせたいしその結果をまとめて PR のマージ可否に使いたい、というとても普通のことを実現するためにいろいろやる必要があるのでしょうか。
一つは、GitHub の status check に自由度が足りないことが主な面倒さの原因といえるでしょう。test-A, test-B が走りそうなら require というのがやりたいことなのですが、そういった表現ができない。これはまあ GitHub が CircleCI の実行グラフを管理していないので仕方ないところではあります。
monorepo 運用されている皆さんはどうしているのでしょうか。うちのリポジトリが polyrepo をただまとめただけなので nx などの既存ツールの恩恵がないという指摘はあるかもしれません。コメントなどいただけるとうれしいです。また、後述する未解決問題についてもなにかありましたら教えてください。
その他の未解決問題
リリース前の確認で diff が見えない問題
デプロイ時には当然「今デプロイしたら何がでるのか」を把握しておきたいわけです。意図した変更であるか、影響がある箇所はどこだろうかということを念頭において作業をしたいというのは自然な欲求でしょう。
現在動いている component のリビジョンを取ってくることを可能にしておくことで(ECS タスク定義から取ってきたり /revision endpoint があったりするでしょう)、runtime の c0 と、main の c1 という2つのコミットの差分をとってリリース対象を特定することができます。
しかし monorepo で異なるコンポーネントの commit も含まれてしまうのでこの手法が使えません。仕方ないので git log --oneline --merges --first-parent {deployed_revision}..origin/main -- {path_pattern} というコマンドから merge commit を取ってきて PR を一覧にすることで代用としています。
hold クリックするの大変問題
結局 main からデプロイをするときには staging, production 入り混じったグラフから正しい component を選んでデプロイする必要があります。これがオペレーションミスを誘発するのでなんとかしたいと思っています。
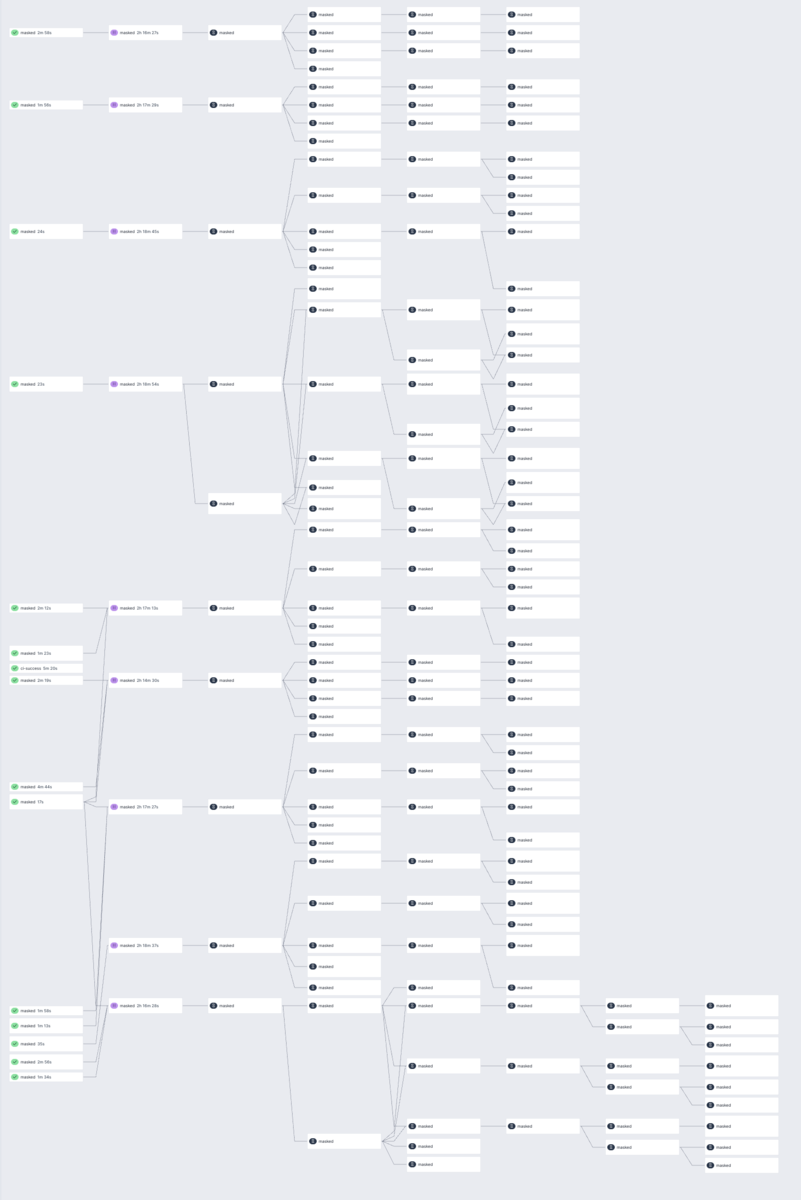
1つの案は staging を auto deploy 扱いにすることです。そうすればとりあえず node の数は約半分になります。しかし、staging の auto deploy にはそれはそれで問題がありそうです。例えば 1 PR の中で複数コンポーネントをいじる場合に、auto deploy ではリリース順序が指定できないため、依存があるならば別PRにしなければなりません。とてもクリーンではありますが厳密にやると面倒なところではあります。
これを解決するために、例えばリリース手順を明示するような手法があるでしょう。 releases/2026-05-01-001.yaml に target: [componentA, componentB] と定義し、動的生成で A → B のリリース順序を保証するなど。しかし複数コンポーネントの順次リリースの場合、不具合発生時の abort flow *5を考慮しなければなりません。また yaml に書き忘れてデプロイされないことの検知などを考えると運用までにはまだまだ詰めるところは多そうです。
Agent が自分でサブディレクトリに cd したのに相対パス指定間違えまくる問題
AI Agent は componentA/ ディレクトリに cd して bin/rspec などを実行するが、その後 git add するときに cd したことを認識せずに誤ったパスを指定してしまいます。だいたい自分で気づくのでクリティカルな問題ではないがターンが増えるので鬱陶しいです。
*1:https://www.treasuredata.co.jp/product/treasure-ai-studio/
*2:私は TD の cdp-api というところで動的 WF 生成で飯を食べている時期がありました https://speakerdeck.com/aamine/treasure-data-techtalk-2022-td-cdp-in-30-minutes?slide=29
*3:別に componentA/circleci.yaml でもよい、というかそっちのが変更検知の観点からはよい気がしてきました
*4:development ブランチ運用については良い点悪い点両方あるのですがまた別の機会に。
*5:ウチには巨大すぎると思って避けていましたが k8s などはこういったものが得意かもしれません
k0kubun/ruby-jit-challenge 完了報告

RubyKaigi 2023 お疲れ様でした。非常に面白かったですね。k0kubun さんのRJITについての発表が面白かったので ruby-jit-challange をやりました。無事完走できたので感想記事を書こうと思います(激ウマギャグ)
※: ベンチマークから rjit が抜かれてる理由は後述
RJIT / ruby-jit-challenge ってなに
k0kubun さんが Ruby で JIT を書けるような機構を作ってくれました。それをRJITと呼びます。RJIT を手を動かして体験できるチュートリアルが公開されています。親切なREADME、命令列をJITするところ以外の部分、機械語生成用のヘルパーも用意されておりおもてなしの精神がすごい。みんなぜひやりましょう
なお冒頭で16倍はやいっていっていますが、特定ベンチマークにしか対応しておらず、そのへんの ruby スクリプトのうち1%もまともに動かないような状態だと思います。これをちゃんと全部カバーするとどんどん遅くなるんでしょうね……。
やろうかなと思っている人へ
やりましょうとは言いましたがやる人が挫折しないようにアドバイスを。
ヒントは見るべき
README にヒントがありますがヒントを見るのをためらわないでください。私はCコンパイラ自作ちょっとやってみたし、MRI の実装眺めたり適当にいじったりしたこともあるからヒントなしでいけるか〜とか思ったけど全然いけませんでした。ヒントなしで要求されることは例えば以下のようなことになります。
- YARV の命令列を見て意味がわかる
- 命令の name 以外の情報がどこにあるかわかる
- nil や false や Integer が RVALUE としてどういう byte 表現になっているかわかる
- スタックマシンを前提としたアセンブリがどんなもんかわかる
- RJIT Compiler 上から必要なデータに触れればいいかわかる
(他にもあったような気がするがぱっと出てこない)
上述の知識がないという自覚がある人はヒントをガンガン読んでそこから学べばよいと思いました
やってみたらプロセスが返ってこなくなった
実質アセンブリ書いてるようなもんなのでSEGVとかcfp不一致とかでひたすら怒られるわけですが。ruby/ruby とかでそんなことが起きても特に問題なくプロセス終了してくれるじゃないですか。今回はそういう安全機構も自分で書かないとだめらしいです(というのを飲み会で聞いた気がするが間違ってたらすみません)。そんなことやってられないので踏んだら docker コンテナをまるごと落としましょう。だいたい以下のようなコマンドをやってました
# bin/ruby の引数とかオプションは開発状況に合わせてお好みで。
$ docker run --platform linux/amd64 -it -v "$(pwd):/app" k0kubun/rjit bash -c "bin/ruby --rjit-dump-disasm test/lt.rb"

# かえってこなかったら別タブでこんな感じに。grep とかは一意に指定できる程度にどうぞ
$ docker ps | grep k0kubun | awk '{print $1}' | xargs docker kill
bin/bench で rjit が落ちる
なんか僕の環境だと落ちました。test/fib.rb の時点で落ちるけど。k0kubun さんに報告しているのであんまり深追いしていません。
https://t.co/X4mR4GCNYu
— はくどー (@HKDnet) 2023年5月25日
使ってる docker image とコミット(といっても関係ない気がするけど)とコマンドのせときました。ふいんきでやってるためこっちがおかしかったらすみません。
どうだった?
面白かったですね。Cコンパイラ自作頓挫勢ですが、アセンブリのDSLがよくできていて、文字列操作で書いてたのに比べてずいぶんきもちよかったです。実際何もかもを捨て去ったJITコンパイラだととりあえず10倍くらいはやいのがかけるってのは素直にすごいなーとなりました。そういえばCコンパイラよりもより局所的にアセンブリを書くことになるのでそういう意味でもこっちから入門したほうが楽かもしれません。
コンテンツ的に面白かったし自分がJIT書くってことが人生であると思ってなかったので id:k0kubun さんに感謝。また、こんなに面白かったのに完走報告がいままでなかったらしいのでみんなやればいいのに〜という感じで記事を書いています。
完走おめでとうございます! (自分以外で初めて見ました) エクストラステージとしてはローカル変数にもレジスタを使うようにすると更に速くなると思います
— k0kubun (@k0kubun) 2023年5月25日
↓僕の実装です。まあ特に見る必要はなく本家の正解ブランチを見ればいいと思います。
オフラインリアルタイムどう書く問題作成リハビリ #0 の回答
社内で英語の技術発表をした
しました、というだけなのですが一応備忘程度に書いておきます。詳細な内容については社外に出せないのでこの記事で紹介することはありません。ご了承ください。
内容は、前Qくらいまで開発していた新サービスと、今開発してる新サービスについてのご紹介。product requirement の話もちょっとしたけど主にはテクニカルにどういう課題があってどういう設計にしてどこが大変だったのかとかそういう話でした。ボリューム的には40分くらいで発表が終わり、質疑応答を追加で、という感じ。スライド枚数でいうと33枚でした。
会自体はそもそも開発チームのもちまわりで社内 Tech Talk を順番に回していくような会があり、うちのチームからも誰かやってくれ〜という話になってやりました。あんまり自分からこういうのに立候補するようなタイプじゃないので上からやってくれっていうのが振ってきたのはいい機会だったような気がします。自分からやらないという理由は、やったこと・理解したことについてブログ書いたり資料作ったりすると、「いやこれもう知っててつまんねえな」「なにを当然のことをぐだぐだと」という気持ちが先立ってしまい興味が消えていくというのが主因です。今回の依頼はそもそもチーム外の人への説明なのでオーディエンスが明らかであり、またチームメイトと話してたら確かに最近やってたことはおもしろいなと認識できたのでなんとかやりきることができました。
発表については、日本語だと早口になりがちという問題がありましたが、英語だと文章が出てくるまで詰まることがあるので、たぶん、そうでもないんじゃないでしょうか。しらんけど。いや、振り返ったほうがいいのは知ってるけど自分で自分の英語を聞くととてもつらくなるので全然聞けていません。「ときどき詰まるけど詰まってないところは早口」という最悪ケースをいま思いつきましたがまあ忘れます。
日本語の資料だと、文字を少なめに、口頭での説明でカバーするスタイルを目指しているのですが、英語だし、話すよりも書くほうが得意なので割と文章をスライドに書くスタイルにしちゃいました。zoom 時代だから資料が見にくいこともあんまりないし。図がばーん、みたいなページもいくつかはあったのですが、スピーカーノートにカンペを書くことによりだいたい読んでればOKという状態にもっていけました。まあ実際の発表だとテンションがあがってあんまりカンペを見なかったりするんですが……。
全体としてはよくできたと思っていて、内容ももりだくさんだったし質問もたくさんもらってたくさん答えました。1回、質問者の英語を正しく聞き取れず、とんちんかんな答えをしてしまったのが悔やまれますね。チームメイトが表れて正しく回答して去っていったのに助けられました。
割と楽しかったのでまた*1やってもいいなと思いました。
*1:1年後くらいに
AWS Lambda Function と Go でシュッとやってバーンってしたい
前提
最終形
Lambda Function + Function URL w/CORS を立てる。バイナリは↓で作っておく。
なお以下のソースコードは既存のものから不要なものを載せないよう切り貼りしたものであり、これ単体での動作確認は行っていないので雰囲気で読み取ってください。
// cmd/lambda/main.go
package main

import (
    "github.com/aws/aws-lambda-go/lambda"
    "github.com/awslabs/aws-lambda-go-api-proxy/httpadapter"

    "github.com/hkdnet/tekitou/handler"
)

func main() {
    mux := handler.NewHandler()
    lambda.Start(httpadapter.NewV2(mux).ProxyWithContext)
}
// handler/handler.go
package handler

import "github.com/gorilla/mux"

func NewHandler() http.Handler {
    // なんでもいいけどとりあえず gorilla にしておく。
    r := mux.NewRouter()
    // てけとーにルーティング足す
    return r
}
ローカル確認はこんな感じにしておくとよい。
// cmd/local/main.go
package main

import (
    "fmt"
    "net/http"
    "os"
    "strings"

    "log"

    "github.com/hkdnet/tekitou/handler"
)

var corsHeaders map[string]string

func init() {
    corsHeaders = make(map[string]string)
    corsHeaders["Access-Control-Allow-Origin"] = "*"
    corsHeaders["Access-Control-Allow-Methods"] = "GET,PUT"
    corsHeaders["Access-Control-Allow-Headers"] = "content-type"
}

// CORS header. This is set by Lambda Function URL in production. Our lambda handler doesn't need to care CORS.
// But in local we do need it.
func setCorsHeaders(h *http.Header) {
    for k, v := range corsHeaders {
        h.Set(k, v)
    }
}

type respWriterWithCors struct {
    w http.ResponseWriter

    wroteHeader bool
}

func (w *respWriterWithCors) Header() http.Header {
    return w.w.Header()
}
func (w *respWriterWithCors) Write(b []byte) (int, error) {
    if !w.wroteHeader {
        w.WriteHeader(http.StatusOK)
    }
    return w.w.Write(b)
}
func (w *respWriterWithCors) WriteHeader(statusCode int) {
    h := w.Header()
    setCorsHeaders(&h)
    w.w.WriteHeader(statusCode)
    w.wroteHeader = true
}

func main() {
    h := handler.NewHander()

    http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) {
        if strings.EqualFold(r.Method, "options") {
            h := w.Header()
            setCorsHeaders(&h)
            fmt.Fprintf(w, "")
            return
        }
        w = &respWriterWithCors{w: w, wroteHeader: false}
        h.ServeHTTP(w, r)
    })

    log.Println("start listening")

    err := http.ListenAndServe(":3001", nil)
    if err != nil {
        fmt.Fprintf(os.Stderr, "%s", err)
        os.Exit(1)
    }
}
紆余曲折部分
普通にやってると aws-lambda-go にいきつくと思うんだけど、これはそもそもリフレクションバリバリつかっていてちょっと追いにくい。
そして Function URL を使えば API Gateway なくてもいいらしいという風のうわさを聞いたものとしては API Gateway をはさみたくない。ついでにいうとルーティングも自前で解析しないで Go の既存のWEBフレームワークとかにお願いしたい。
そのへんを解決してくれるのがこれ。
Function URL 対応とは一言も書いてないが API Gateway V2にすれば普通に動く(ということはおそらく Function URL + aws-lambda-go の APIGWv2でも動くはずだが未検証)。でもとりあえず http.Handler なものを返せば動いてくれるので考えることが減って楽
次の問題はどうやってローカル確認するか。これも http.Handler があるので上述のように cmd を2つに分けてローカル確認用と実際にLambdaに置く用でそれぞれエントリポイントを用意すればよい。
ここまできて最後の問題がCORS設定。Function URL は CORS の設定があるのでこれをそのまま使えたほうが楽。だけどローカルでは当然そんな便利なやつはないので書く必要がある。それが respWriterWithCors 部分。ローカルでサーバを立てる前に ResponseWriter をラップしてあげればよい。
これでだいたい動くものができるので、あとは中身をどうにかするだけ。
謝辞
本記事の構成にいたるまで、takeshinoda さんにアドバイスをたくさんいただきました。ありがとうございました!
GitHub + Terraform Cloud で不幸にも workspace が大量にあるときに変更がある workspace だけピックアップするやつ
workspace が大量すぎて困っている人は通常あんまりいないと思うが弊社では非常に役に立っている。
以下のブックマークレットを作って叩けばよい。
javascript:(function(){ [...document.querySelectorAll('.merge-status-item')].filter(e => e.textContent.includes("Terraform plan has no changes") || !e.textContent.includes("Details") ).forEach(e => {e.className = ''; e.style.height = 0; e.style.padding = '0'; e.innerHTML = ''}) })()
2021年12月の近況
この記事は
この記事は Rubyist近況[1] Advent Calendar 2021 - Adventar の5日目の記事ですが、現在2021年12月23日18時くらいです。これは、5日目の投稿をブッチしたわけではなく、空いているので埋めているのであり、私が怠惰であることを示すわけではないということを念の為書いておきます*1。
4日目は、zunda さんの記事でした。
近況
近況は99日前のこの記事でだいたい書きましたが、重複することも含めてつらつら書きます。
仕事
相変わらずトレジャーデータというところに勤めています。Ruby も書いています。ここ2週ほど手元でゴニョゴニョしてるのは Go と JavaScript ですが、チームのメインリポジトリは Rails ですし、主な仕事もそっちです。Ruby のお仕事は弊社でもまだたくさんありますので、ご興味がある方は僕にご一報のうえ、こちらからどうぞ。無事採用となった場合にはリファラルボーナスがあった気がするのでとてもよいご飯を還元できると思います。
なんか年明けくらいにうちのチームの Senior Engineer のヘッドカウントが復活しそうなので、日本か US かカナダで働けてウェブアプリケーションを書いたり直したり運用したりするのが得意な人はうちのチームで僕と激ヤバプロジェクトのアサインを押し付けあったりしましょう https://t.co/EvyShj5cAc
— Shimpei Makimoto (@makimoto) December 1, 2021
仕事内容としては、エンタープライズ〜という感じの機能を作ったり、英語を読んだり英語を書いたりしています。せっかくなのでビッグデータ〜という感じに近い機能についてもガリガリやりたい気持ちはありますが、めぐり合わせとかの関係もありやってませんね。あんまり自分のキャリアや好みの領域に明確な指針がなく、会社としてこれやりたいんですね、じゃあ空いてるんで僕入りますか、みたいな感じになりがちです。
英語は相変わらずそんなにできないわけですが、英語がどうこうというより多数の言語、タイムゾーンに属するメンバーがいる中でプロジェクトを前にすすめるというところをちゃんとやっていく必要があり、それには胆力が必要となることが多く、やっていき〜という感じです。ちゃんとやっていけてないからこんなことを書いているわけですが。規模的には当然自分でなにかやったら全部終わるみたいになることが少なく、開発側だけでもチーム横断になるし、プロダクト側ともいい感じにやっていく必要があり、それをちゃんと終わらせるというのはやはり労力がいるものだなあと思います。
仕事2
副業のほうも続けているわけですが、こっちもこっちでありがたいことに人が増えてきており、ただの開発者としてではなく、どうやったら全体としてのアウトプットがいい感じになるかということを素人ながら考えたりしています。
人が増えているとは言いましたが、フロントエンドの人がまだまだ足りてないので募集中です。副業とか業務委託からお願いすることになると思うのでこのへんを読んで興味がありましたらぜひ。なおこちらについても応募前に僕にご一報いただけるとリファラルボーナスがありますのでなんらかの還元ができると思います。
ファンファーレの副業エンジニアについて記事になりました!
— ゆきと / 廃棄物Tech企業のCEO (@Yukito_tweet) December 15, 2021
・副業割合70%越え
・ドメイン知識が、すごーく必要
・ほぼ非同期コミュニケーション
という環境下でも、とても優秀な方々が集まり、わいわい開発してます🐶🦊🐯🐸https://t.co/DbLmSbChUs
生活
相変わらず料理をずっとしています。まだ飽きないですね。仕事でヘロヘロだったりすると作る気にならなかったりしますが。最近はあまりに日常になりすぎたせいで特に写真撮ったりもしなくなりました。趣味であり、生活の一部であるという。
家ではビールをやたらと飲んでいたのですが、特に飲むぞうおおおという気持ちでないときにはご飯と一緒ならビアリーでよい気がしてきました。もちろん酒を味わうぞというときには物足りないのですが。ノンアル系はどうにも苦手なのですが、ビアリーには慣れたのでこのまま進めばいけるようになるかもしれません。というか別に常備されてればジンジャーエールとかでもいいという説はあります(未検証)。健康のためにはアルコールが少ないほうがいいのはそのとおりなのですが、特に財布への負荷が軽くなってないのが気になるところではあります。別にお金のかかる趣味があるわけでもないので食と酒には好きにお金を使っていいとは思っているのですが、低アルの割には高いですよねという気持ちになってしまう*2。ビール以外にも日本酒をよく飲んでおり、近くに好きな酒屋も出来たのですが、いかんせん酒自体を記憶するのが非常に苦手で、ブログに書くほどの何かはありません。
そういえば家がほしい気持ちが高まり、いろいろなんやかんやしています。2人暮らしが1年経ちだいたい必要な家の感じとかがわかってきたこと、今の家の家賃を考えると買ってしまってもだいたいなんとかなること、結婚式も終わり新しいことを検討する余裕ができたことなどからです。家、何もかもがわからず、ひたすらブログやら情報サイトを眺めたりしてなるほど〜という気持ちになったりしています。
娯楽系でいうと、一時期SEKIROブログになっていたようにせきろにかなりの時間を費やしていました。トータル120時間だそうです。ゲームはじゃあしばらくいいかな、と思っていたところハロウィンセールかなにかで兄がダクソ3を始めたらしく、じゃあやるかと思っていまはダクソ3をやっています。こっちはまだ43時間程度なので安心ですね。1周目を脳筋ビルドでラスボス倒してDLCがまだ、といったところですが、歯ごたえが足りなく感じてきたので新プロフで始めているところです。難易度については、SEKIROよりかんたんな気がしますね。SEKIRO は基本的にボスに勝つためにはボスを理解する必要がありますが、ダクソ3のほうではそもそも探索真面目にやってたらレベル上がってゴリゴリ殴ってたら勝てるみたいになりがちでした。完成がはやい脳筋ビルドなせいもあるとは思います。ちゃんと理解していかないと勝てないくらいのレベルに抑えたい。
終わりに
本記事の序文は敬愛する id:takeshinoda パイセン*3の記事を参考にさせていただきました。
また、こうした近況を書いて投稿する機会を作ってくれた、id:takkan_m さんもありがとうございました。といっても忘年会に参加したことあったかなかったかあやしいですが……。
*1:なお当然ながら私が怠惰でないことを示すわけでもありません
*2:それを突き詰めると工業用アルコール飲んでろ、になるのもわかっています
*3:このフレーズも https://twitter.com/highwide/status/1470691534681313281 を参考にさせていただいています
